
主题
正则查找替换/测试
一份两千行的日志要把所有手机号替换成 ***;或者从一堆 URL 里把参数部分统一去掉。手工改不现实,正则是唯一可行的办法——但写错一个字符就可能把整份文本改坏。
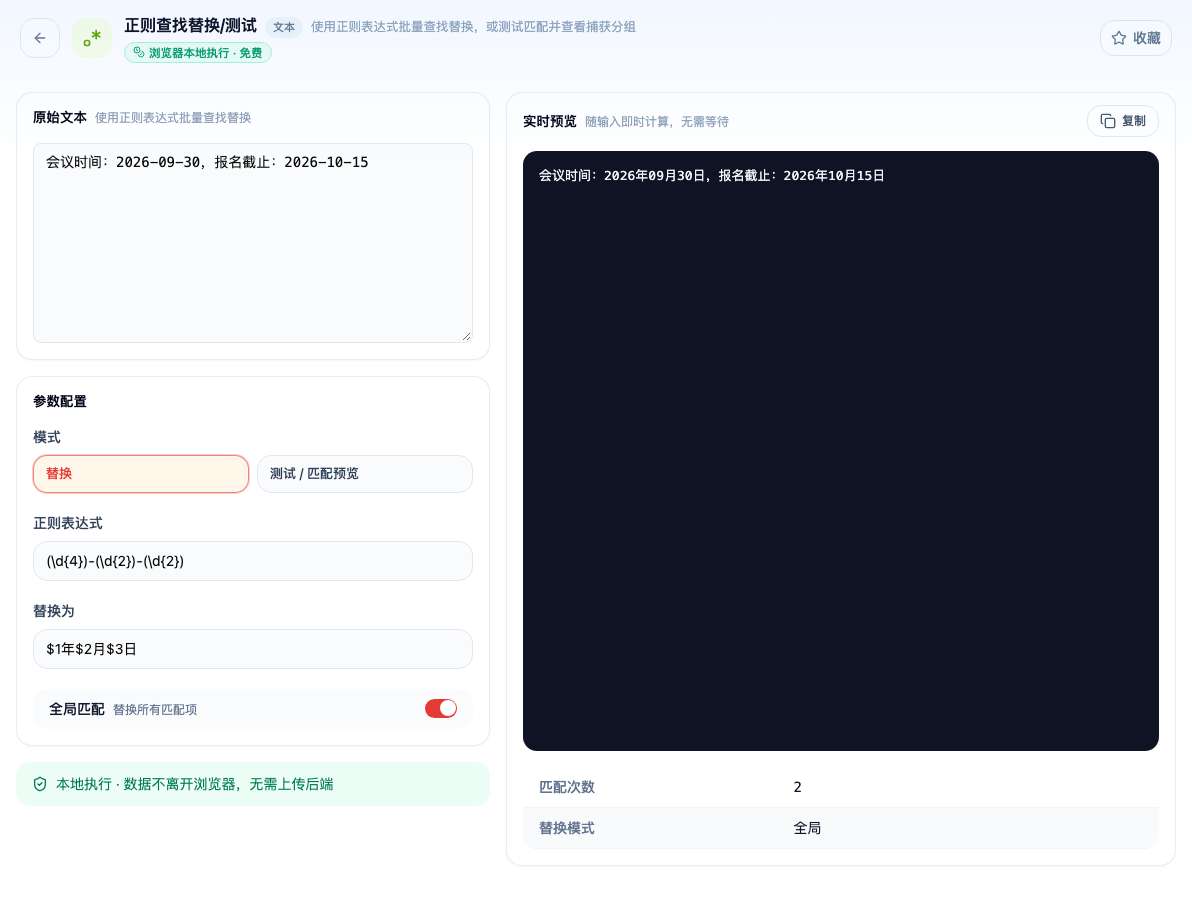
「正则查找替换/测试」填入示例输入后,右侧即时给出结果(图中数据为示例)。在浏览器本地完成、数据不离开浏览器,免费。
先测试,再替换
工具有两个模式,顺序不能反:
测试匹配——只显示命中了什么、每个捕获分组各是什么,不改动原文。
查找替换——真的替换。
正确用法:先在测试模式下看看究竟命中了什么。正则的常见事故不是「没匹配上」(那你会立刻发现),而是匹配范围超出预期——本想改 5 处,实际改了 50 处,而结果看起来还挺正常。
贪婪匹配:最常踩的坑
.* 是贪婪的,它会匹配尽可能长的内容。
想从 <b>粗体</b>和<b>另一个</b> 里去掉标签,写 <b>.*</b> 会一口气匹配到最后一个 </b>,把中间的「和」也吞掉。
正确写法是加问号变成非贪婪:<b>.*?</b>。
判断方法:在测试模式下看匹配结果的长度。明显比预期长,就是贪婪的问题。
几个高频写法
| 目标 | 写法 |
|---|---|
| 手机号 | 1[3-9]\d{9} |
| 邮箱 | [\w.-]+@[\w.-]+\.\w+ |
| 连续空行 | \n{2,} |
| 行首空白 | ^\s+(需开多行模式) |
| URL 参数 | \?[^\s]* |
捕获分组:调换顺序用得上
用括号捕获,替换时用 $1、$2 引用。
把 2026-09-05 改成 09/05/2026:
查找:(\d{4})-(\d{2})-(\d{2})
替换:$2/$3/$1这是正则最有价值的用法之一——不只是删改,还能重排结构。
全局匹配这个开关
默认开启,替换所有命中。
关掉只替换第一处。用得少,但在「只想改文件里第一次出现的那个」时有用。
一条纪律
替换前把原文另存一份。 正则替换在这个工具里是一次性的,改坏了没有撤销。写得越复杂越要留底。
浏览器本地处理
文本不上传服务器。日志、用户数据可以放心处理。