
主题
辣椒Agent 能做什么
和只会生成文字的聊天机器人不同,辣椒Agent 在回答之前会先判断:这个问题需不需要动手?需要的话调哪个工具、按什么顺序调。
四类能力
调用工具。 平台上的工具它基本都能调。你说「把这个 PDF 压缩一下」,它会去调 PDF 压缩,而不是告诉你「你可以使用某某软件」。多步任务也能串起来——翻译完再转 PPT,中间产物自动传递。
读你的文件。 上传的文档、表格、图片、音视频,它会先解析再回答。PDF 会提取正文与表格,图片会真的「看」(不是靠文件名猜),扫描件会走 OCR。
联网查资料。 需要时效信息时会去搜索,并且给出真实来源链接。搜不到或对方拒绝访问时,它会明说「这一篇没读到」,而不是把标题当成读过的内容写进答案。
记住你。 开启记忆后,它会记下你的长期偏好和背景(做什么工作、习惯什么格式),下次不用重复交代。
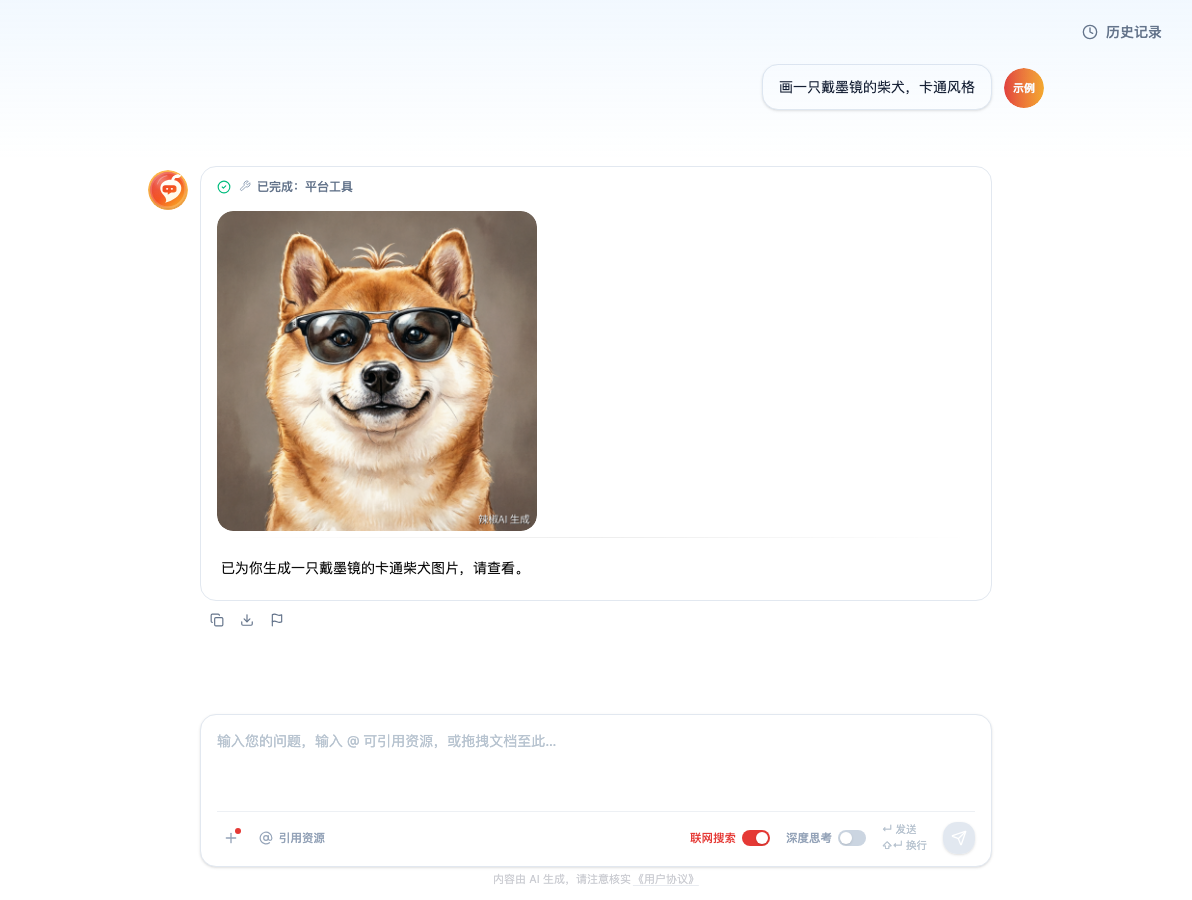
一句话生成图片:Agent 自己选用文生图工具,图片直接出现在回答里,带「AI 生成」标识(图中为示例对话)。
几个用得上的场景
让它替你处理一批文件。 「把这几张图拼成长图,再压到 2MB 以内」——多步、有约束,正是它的强项。
让它解释而不只是给结果。 「这份合同里有哪些对我不利的条款」比「总结这份合同」得到的东西有用得多。
让它出可编辑的东西。 生成 PPT 给的是原生形状和文本框,不是图片;生成流程图给的是可继续编辑的源文件。产出能接着改,比一次成型更重要。
三条能显著提高效果的习惯
给结构,不要只给主题。 「做一份新能源汽车的 PPT」它只能自己编大纲;把你想讲的三五个要点先列出来,产出立刻不一样。
说清不要什么。 生成类功能的默认倾向是「多」——多加几页、多写几句。页数上限、字数上限、不要配图,这些必须明说。模糊的「简洁一点」几乎没有作用。
看渲染后的成品。 PPT 文字溢出文本框、流程图连线交叉,这些在数据层面都正常,只有导出成图才看得见。
它会拒绝什么
涉及违法违规、侵犯隐私、伪造证明材料一类的请求会被拒绝。内容安全检测在入口和出口两侧都有。