
主题
PDF 敏感内容涂黑
要把一份合同作为案例发出去,但里面有客户名称、金额和身份证号。最常见的错误做法是:用 PDF 编辑器画几个黑色矩形盖住——那不叫涂黑,那叫盖了张纸。
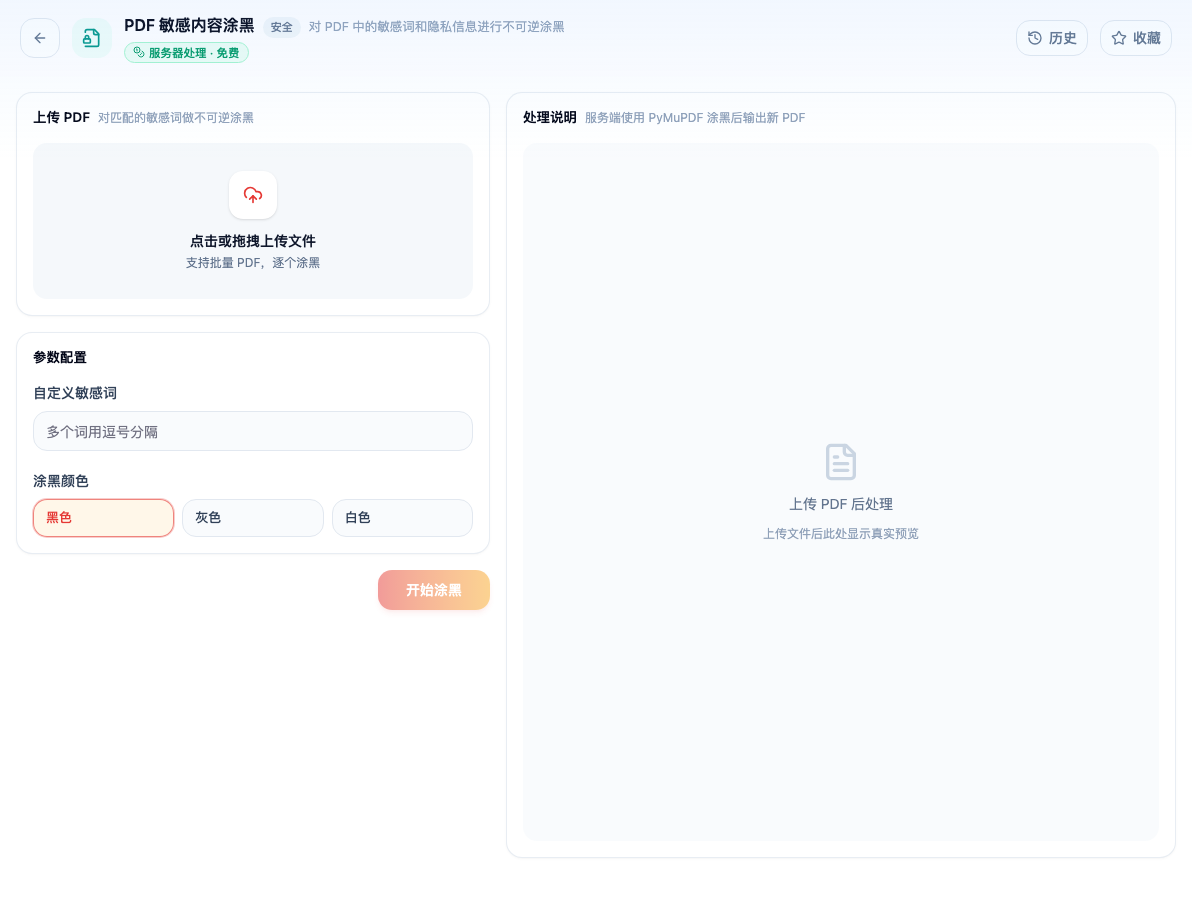
打开「PDF 敏感内容涂黑」看到的初始界面。在服务器端处理,免费。
为什么画黑框没用
PDF 是分层的。你画的黑色矩形是新加的一层图形,被盖住的文字原封不动地还在文件里。
对方要看到它只需要:用鼠标框选那块区域然后复制粘贴;或者用任何 PDF 转换工具转成文本;或者干脆在阅读器里搜索关键词——搜得到,因为文字还在。
这不是理论风险。历史上多起政府文件泄密事故就是这么来的:发布方以为盖住了,实际只是加了一层看得见的遮罩。
这个工具做的是不可逆删除
它的处理是:先把匹配到的文字从内容流里删掉,再在原位置画上色块。删掉的部分不存在于文件的任何一层,复制不出来、搜不到、转换工具也提取不到。
代价也在这里:不可逆。涂黑后的文件里那些内容是真的没了,你自己也恢复不了。所以务必保留原始文件。
怎么用
自定义敏感词里填要涂掉的内容,多个词用逗号分隔。填的是精确文本,比如公司全称、具体金额、身份证号。
两个要注意的点:
同一个信息可能有多种写法。 「北京华胥星辰有限公司」和「华胥星辰」是两个词,都要填。金额也一样——「1,000,000」和「100万」是两串不同的字符。
涂完必须自己验证一遍。 打开结果文件,用阅读器的搜索功能搜一遍那些敏感词,确认搜不到。这一步不能省:万一某个变体写法没覆盖到,你会在完全不知情的情况下把它发出去。
涂黑颜色
默认黑色。选白色可以做成「留白」的效果,看起来像原本就没有这段内容——但要注意这在某些正式场景里不合规,涂黑的痕迹本身也是信息(说明这里有内容被删除)。
处理不了的情况
扫描版 PDF。 里面是图片没有文字,按文字匹配自然找不到。扫描件需要先 OCR 或者用图片编辑工具处理。
跨行断开的内容。 一个身份证号如果在版面上被折成两行,作为一个整串可能匹配不到。这类要拆成两段分别填。
图片里的文字。 页面上插入的截图里如果有敏感信息,本工具处理的是文本层,动不了图片内容。