
主题
把回答导出成 Word、PDF 或 Markdown
每条助手回答底部有「下载」菜单,三个格式:
| 格式 | 适合 | 怎么生成 |
|---|---|---|
| Word (.docx) | 要继续编辑、发给别人改 | 浏览器里直接合成,不走网络 |
| 定稿、打印、公式多 | 服务端矢量排版,文字可选中,公式和表格不会跨页截断 | |
| Markdown | 进笔记软件、进代码仓库 | 纯文本 |
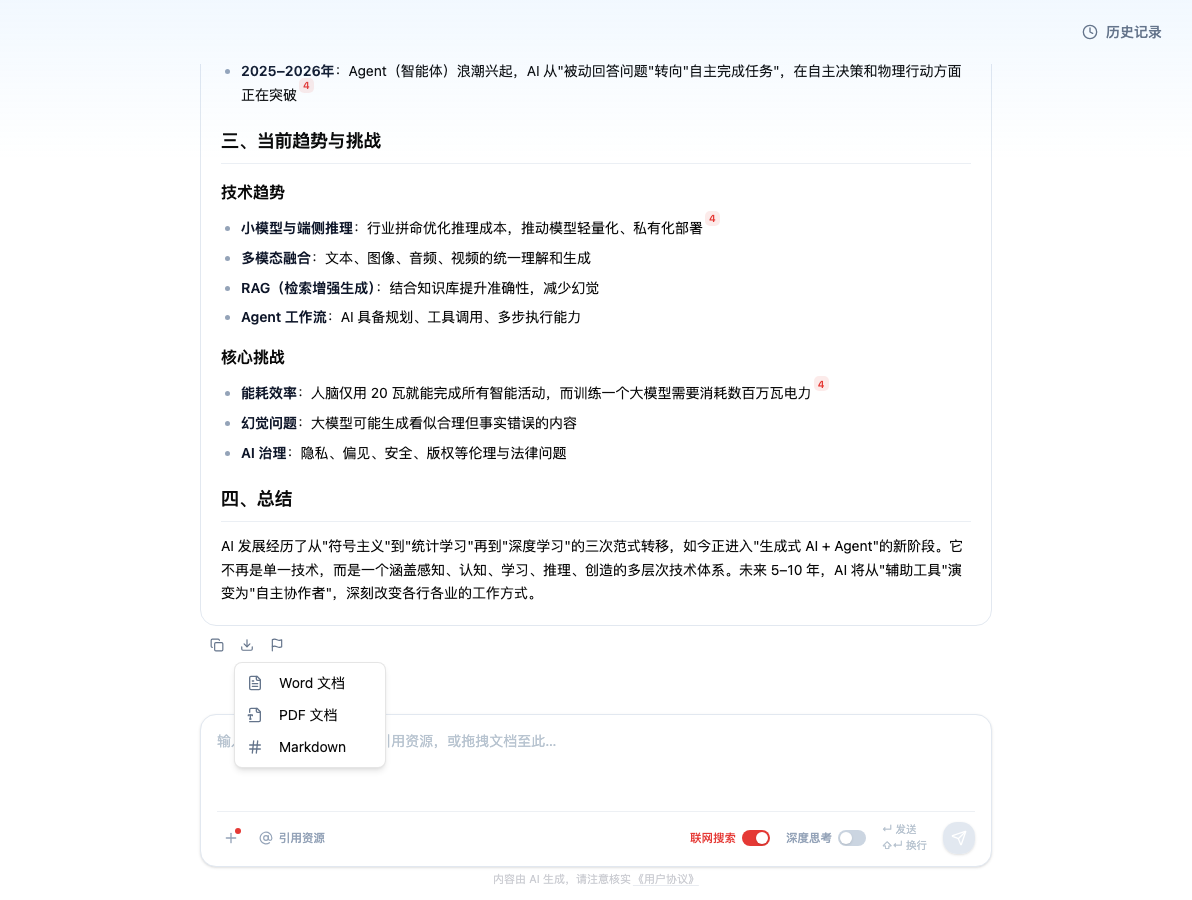
回答下方的下载按钮,可以选择导出为 Word、PDF 或 Markdown。
图片会跟着走
对话里 AI 生成的图片、工具产出的图,导出时会按回答里的原始顺序嵌进文档,A4 版心等比缩放(只缩不放,小图不会被拉糊)。
这一点曾经做错过:第一版导出的是回答的纯文字部分,图片全丢,而且连「这里本来有张图」都看不出来。原因是回答的文字和产物在数据上是分开存的——现在的导出走的是完整的内容块序列。
取不到的图会留占位(在原位置明确标出获取失败),绝不静默跳过。静默丢图你根本发现不了,比明着标出来危险得多。
什么不会被导出
- 思考过程、工具调用的中间步骤——只导出正文和产物
- 多文件产物(比如「PDF 转图片」出来的几十张)——这类不是「回答里的插图」,去产物卡片里下载压缩包
- 引用角标背后的原文——角标保留,原文不展开
导出整段对话
目前是逐条回答导出。要整理一段完整对话,先让 Agent「把上面的讨论整理成一份文档」,再导出那一条——顺便还能让它去掉过程口水话。
PDF 那条路和工具箱共用
PDF 导出与工具箱里「Markdown 转 PDF」走同一条服务端渲染路径(WeasyPrint),公式先转成矢量路径再排版。你在工具页看到的效果,就是导出的效果。