
主题
文本清洗脱敏
要把一批客服对话记录发给外部标注团队,里面夹着用户的手机号、订单号和身份证。人工一条条删不现实——几千行,而且漏一条就是事故。
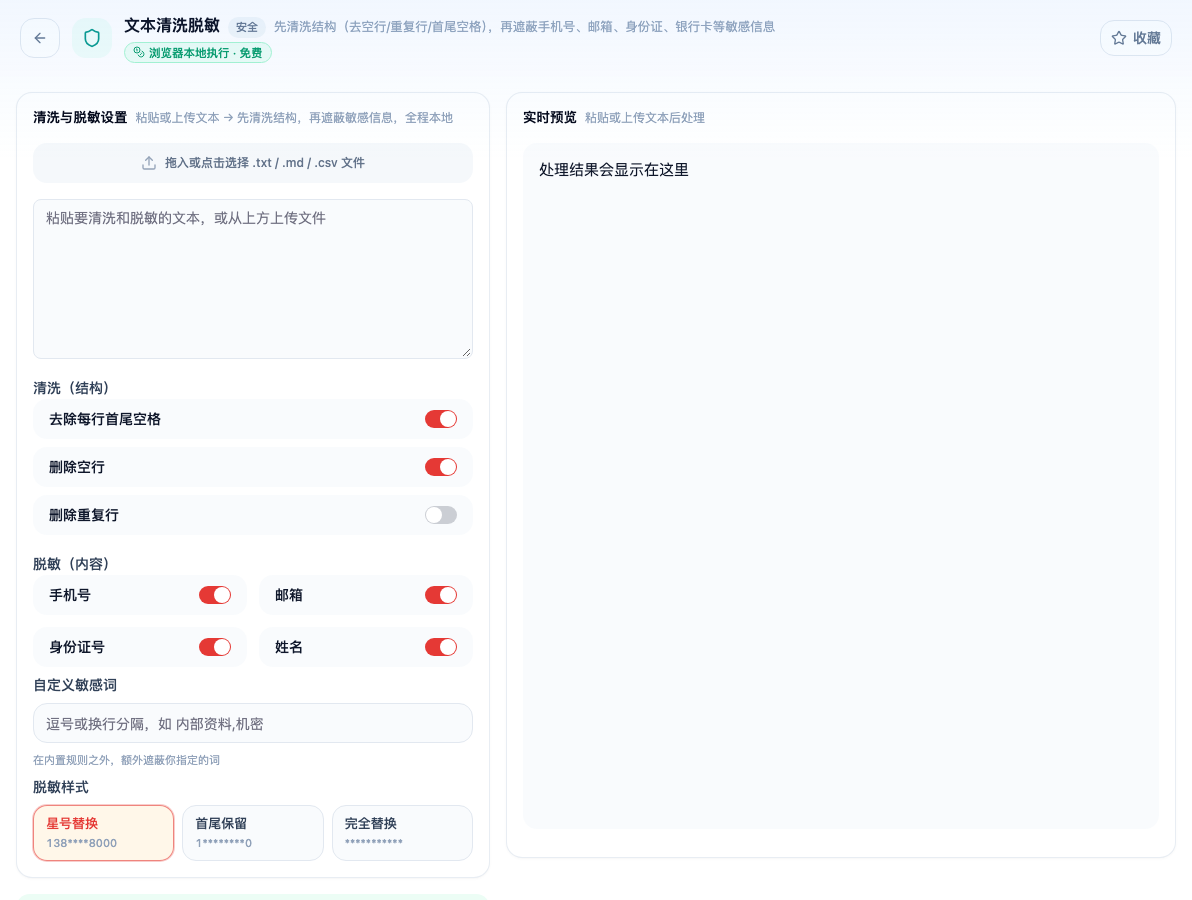
打开「文本清洗脱敏」看到的初始界面。在浏览器本地完成、数据不离开浏览器,免费。
两件事,顺序不能反
工具做的是两步,先清洗结构,再遮蔽内容:
第一步·清洗——去掉首尾空格、删除空行、可选去重复行。这一步看着琐碎,但它决定了第二步的准确率:一个手机号如果被莫名其妙的空格拆成两段,正则就匹配不到了。
第二步·脱敏——按类型识别并遮蔽:姓名、手机号、邮箱、身份证、银行卡。
各类型识别的可靠程度不同
| 类型 | 可靠程度 | 说明 |
|---|---|---|
| 手机号 | 高 | 11 位、固定号段,几乎不会漏 |
| 邮箱 | 高 | 格式特征明确 |
| 身份证 | 高 | 18 位且末位校验位可验证 |
| 银行卡 | 中 | 位数不固定,可能与其他长数字混淆 |
| 姓名 | 低 | 见下 |
姓名是最不可靠的一项,因为中文姓名没有格式特征——「李明」和「李明」作为普通词组无法从字面区分。它靠的是姓氏表加上下文推断,必然有漏有误伤。
所以:脱敏之后必须抽查,尤其是姓名。别把「跑完工具」当成「处理完了」。
什么时候关掉某个开关
去除重复行默认是关的,因为重复行在日志里往往有意义(同一个错误出现 50 次是重要信息)。只有在处理名单类数据时才开。
脱敏姓名如果误伤严重(比如文本里大量出现产品名被当成人名),可以关掉它单独处理。
浏览器本地执行
这个工具在你自己的浏览器里跑,文本不会上传服务器。这一点对脱敏工具尤其重要——如果为了脱敏而先把原始数据上传到某个服务器,本身就与目的相悖。
也因此,超大文件(几十 MB 的日志)可能会卡,浏览器内存有限。这种情况分批处理。
脱敏不等于匿名化
一个需要说清的边界:把手机号遮成 138****5678 之后,数据仍可能被还原身份——如果同一条记录里还有城市、职业、购买记录等信息,组合起来足以定位到具体的人。
真正的匿名化需要考虑这类关联风险,不是遮几个字段就完事。涉及合规要求时,脱敏只是第一步。
相关工具
- PDF 敏感内容涂黑 —— 处理 PDF 里的敏感内容
- 文件元数据清理 —— 内容之外的隐藏信息
- 正则查找替换 —— 需要自定义规则时