
主题
PDF 转 Word 排版为什么总是乱
同一份 PDF,换几个转换工具,排版乱的地方各不相同,但没有一个是完美的。这不是工具做得不好,是这件事本身就没有标准答案。
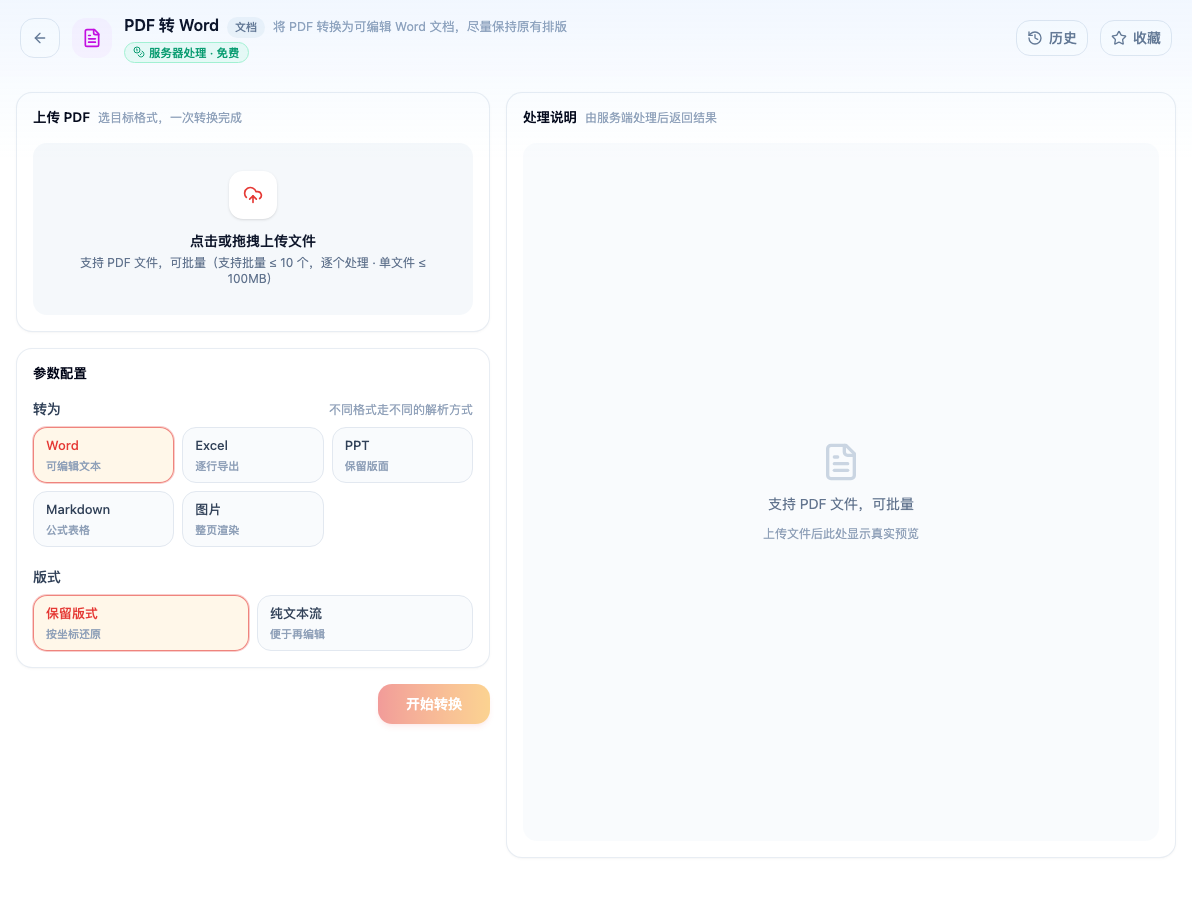
打开「PDF 转 Word」看到的初始界面。在服务器端处理,免费。
两种格式记录的东西不一样
PDF 记录的是最终画面。 它的内容大致是这样:在坐标 (72, 690) 处用 12 号宋体画「第」字,在 (84, 690) 处画「一」字……它不知道哪些字构成一个段落,甚至不一定知道哪些字构成一个词。PDF 是打印机的语言,目标是在任何设备上像素级一致。
Word 记录的是文档结构。 它存的是「这是一个段落,首行缩进 2 字符,两端对齐」,具体每个字落在哪里,由 Word 排版引擎当场算出来。换个字体、改个页边距,文字会自动重新流动。
从 PDF 转 Word,等于要从一堆坐标反推出结构——这是一个猜测过程,不是格式翻译。猜对了排版就正常,猜错了就是你看到的那些乱象。
常见乱象与它们的成因
每行都成了独立段落。 转换器没能判断出这些行属于同一段。PDF 里每一行都是独立绘制的,行与行之间没有任何「同属一段」的标记,只能靠行距、缩进、行尾是否接近页边等线索推断。
表格变成一堆文本框,或者干脆糊成一片。 PDF 里的表格通常只是一些线段加一些文字,没有「单元格」这个概念。转换器需要根据线的位置反推行列结构;如果原表格用的是无框线设计(只靠对齐排版),线索就更少了。
双栏论文的文字左右交错。 转换器按坐标从上到下读,把左栏第一行和右栏第一行当成了连续的两句。需要先做栏位检测,判断出这是两栏再分别读取。
字体全变了。 PDF 允许只嵌入用到的那几个字(子集嵌入)。转成 Word 后,如果你的电脑没装这个字体,Word 只能换一个——而中文字体的字宽差异会让整页排版跟着变。
还有一种:复制出来是乱码
文字明明能选中,复制粘贴出来却是一堆方块或无关字符。这种情况和排版无关,出在字体编码上。
PDF 里的文字实际存的是「字形编号」——第 37 号字形、第 128 号字形。要把编号还原成真正的字符,需要一张对照表(CMap)。生成 PDF 的软件如果没写入这张表,或者写入的是自定义编码,阅读器就只能照着字形画出正确的图形,却说不出那是哪个字。
于是出现一种矛盾的现象:看得清清楚楚,就是复制不出来。这类 PDF 转 Word 的结果通常也是乱码,因为转换器拿到的同样是没有意义的编号。
遇到这种,只能当成扫描版处理——走 OCR,从画面上重新认字。
扫描版是另一回事
如果 PDF 是扫描或拍照生成的,情况完全不同:里面根本没有文字,只有图片。
判断方法很简单:在 PDF 阅读器里试着选中一行文字。选不中、只能框选出一个矩形,就是扫描版。
扫描版必须先做 OCR(文字识别)才能转成可编辑的 Word。这一步会引入识别错误——形近字、模糊处、手写批注都可能出错,转换结果需要通读校对,不能直接用。这不是工具的缺陷,是从像素里认字的固有代价。
怎么少踩坑
优先找原始文件。 这是唯一能得到完美结果的路径。PDF 大多由 Word、LaTeX 或排版软件导出,向作者要一份源文件,比任何转换工具都强。
明确你要什么。 如果只是要文字内容拿去改写,转换结果乱一点无所谓,全选换个样式即可;如果要的是保持排版的可编辑文档,那么复杂版式(多栏、大量表格、图文混排)的 PDF 基本上转完都要手工整理,心理预期要放对。
表格多的文档单独处理。 与其让转换器同时猜段落和表格,不如把表格页单独提取出来转成表格格式,再手工拼回去。
先看是不是扫描版。 这决定了你面对的是「结构推断」还是「文字识别」两个完全不同的问题,处理方式和预期都不一样。
PDF 转 Word 处理的是文字型 PDF 的结构推断。扫描版请用带 OCR 的识别工具,两者不是同一条路径。
没有任何工具能把 PDF 完美还原成 Word——信息在生成 PDF 的那一刻就已经丢了。转换只能尽量猜回来。