
主题
联网搜索与读网页:来源是真的,读不到会明说
来源必须真实
早期版本出过这样的问题:回答里引用的链接全部打不开,因为来源是模型「编」的——它知道大概有这么一篇文章,就凑了个像样的 URL。
现在的搜索走的是能返回真实检索结果的接口,答案里的来源链接全部来自搜索引擎的实际返回。宁可没有来源,也不给假来源——旧版「从答案正文里抽 URL 当来源」的兜底逻辑已经删掉了。
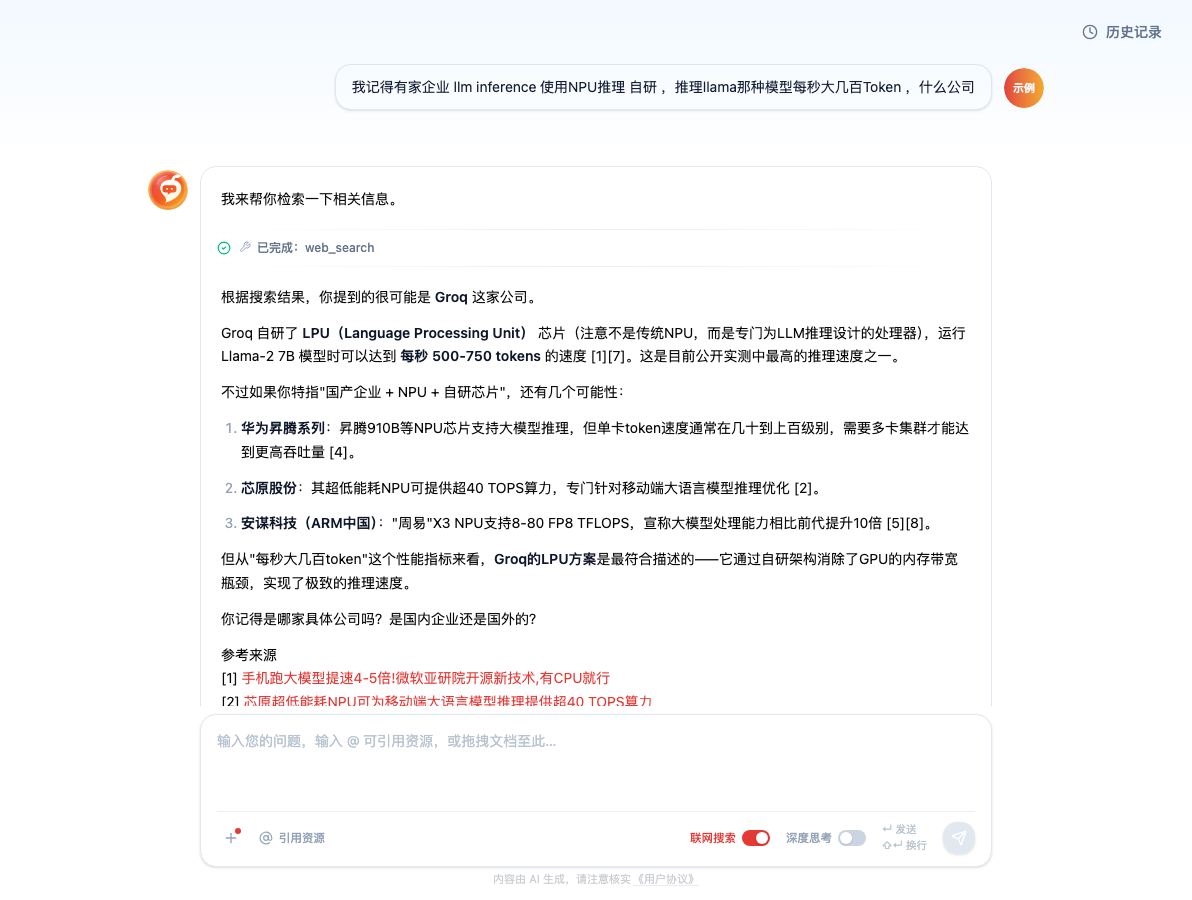
联网搜索的回答:正文里的编号对应末尾「参考来源」中的真实网页,可以逐条点开核对(图中为示例对话)。
搜和读是两步
搜索拿到的是标题和摘要。要引用正文,Agent 会再去读网页——抓取页面、提取正文。一轮回答里通常会搜一两次、读几篇。
读网页可能失败,失败的原因基本就这几种:
| 状态 | 含义 | 能不能再试 |
|---|---|---|
| 403 | 对方拒绝服务器 IP 访问(反爬)或需要登录 | 不能,换什么办法都是 403 |
| 404 | 页面不存在 | 不能 |
| 429 | 对方限流「慢点再来」 | 会自动退避重试一次 |
| 连接超时 | 网络抖动 | 会自动重试一次 |
知乎专栏、部分需登录的站点属于第一种,平台读不到,这是既定事实不是故障。你如果有权限,把正文复制进对话比让它反复尝试有用得多。
还有一种情况是「读到了空壳」:页面返回 200,但正文只有一个标题、几十个字——通常是前端渲染的壳或反爬页。这种现在按失败处理,不会当成「读到了」。
读不到时它应该怎么说
失败的页面在过程区会标红。答案正文里它应当写明「这一篇没读到」,而不是把搜索摘要当成读过的内容写进去,更不该把没读到的链接放进「参考来源」。
这一条靠提示词约束,不能保证 100% 生效。所以看到参考来源列表时,对照一下过程区:过程区里标红的链接,答案里引用它就要打折扣。
什么时候开联网
- 时效性问题(最新版本、近期事件、当前价格)
- 你希望答案附带可核对的来源
- 需要读某个具体网页的内容——直接把 URL 贴给它
不要开的情况:翻译、改写、处理你自己上传的文件。开了只会让它多花一轮判断要不要搜。
成本
一轮带搜索、读了两三篇长文的回答,输入 token 可能到十万级(长网页正文每一轮都会重发)。实扣通常十几积分,可接受,但在同一个对话里连续追问会越来越贵。新话题就新开对话。