
主题
音频转文字
两小时的会议录音,要整理成纪要。人工听打大概要四小时,转写几分钟就出结果——前提是录音质量过得去。
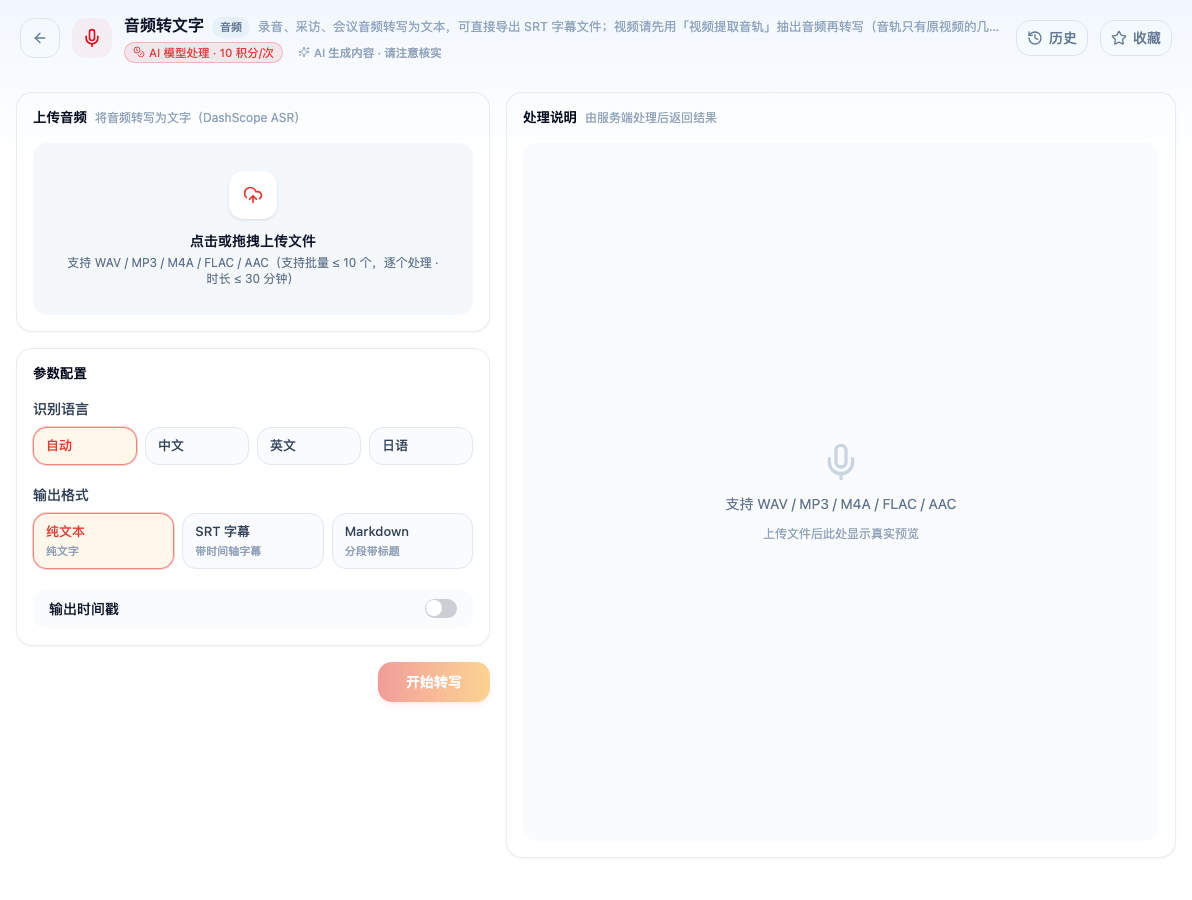
打开「音频转文字」看到的初始界面。由 AI 模型处理,按次消耗积分(以页面标签为准)。AI 生成的结果请自行核实。
先看录音,别急着转
同一个模型,有人拿到的结果几乎不用改,有人满屏错字。差别通常不在模型,在喂进去的音频。
三件事决定识别率:
信噪比——空调声、键盘声、隔壁说话,会和人声抢频段。人耳能自动忽略,模型不能。这一项影响最大。
编码质量——过度压缩的音频(比如转存的微信语音)高频信息已经丢了,而中文的辅音(s、sh、f、x)恰恰集中在高频。丢了高频,「四」和「十」就分不开。
说话方式——多人抢话、远距离拾音、语速过快都会显著拉低准确率,且事后无法补救。
正确的处理顺序
视频要先提取音轨。 直接把视频丢进去,工具会先做一次内部转码,参数你控制不了。先用视频提取音轨拿到干净音频。
噪声大的先降噪。 用音频降噪,这一步必须在转写之前。
过长的先切分。 三小时一次性转写,中途出问题得整体重来,也很难定位是哪一段错的。按议题切开,出错只需重跑一段。
输出格式
纯文本——只要内容,拿去二次加工。
带时间戳 / SRT——每句话带时间。回原音频核对只要几秒,这是它最大的价值;同时也是做视频字幕的输入。
不确定就选带时间戳的——事后想核对时不用重跑。
校对按这个优先级
别从头读到尾,按错误率和后果排:
- 数字和金额——错误率最高,后果最严重
- 人名、公司名、专业术语——模型没见过的词会被替换成读音相近的常见词
- 否定词——「不」「没」这种单音节字最容易被吞,而一旦吞掉整句意思反转
这三类扫完,剩下的错字大多不影响理解。
一个务实的判断
别默认「先转写再修」一定比重新整理快。
录音条件很差时,转写结果可能需要逐句对照音频修改,耗时远超重新听一遍做笔记。
判断方法:随机抽一分钟结果读一遍。需要改的地方超过三处,后面的内容大概率不值得靠修改来救。