
主题
文字转音频
给视频配旁白,或者把一份材料转成音频在通勤时听。
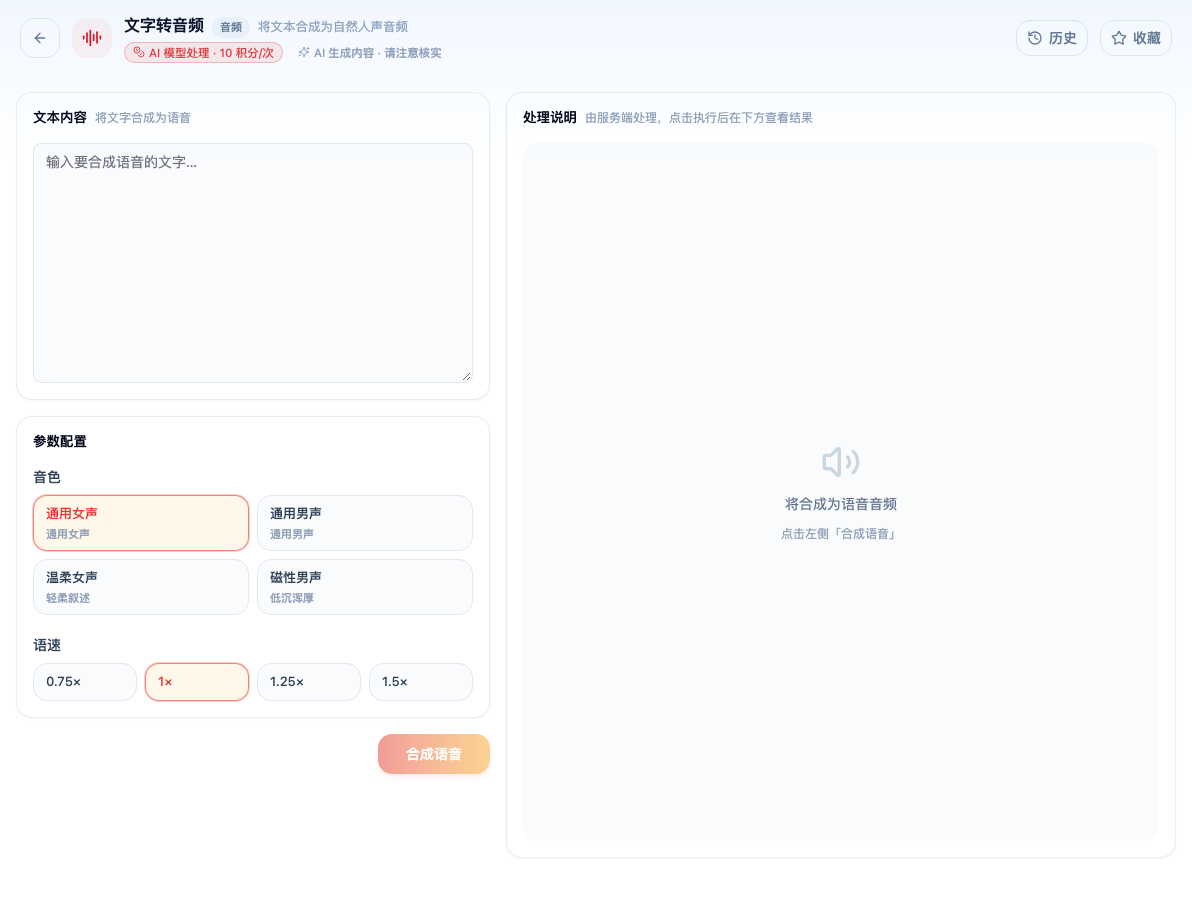
打开「文字转音频」看到的初始界面。由 AI 模型处理,按次消耗积分(以页面标签为准)。AI 生成的结果请自行核实。
决定成品质量的不是音色,是文稿
这是最反直觉、也最有用的一条:换音色带来的改善,远小于改文稿。
为阅读写的句子往往长、从句多、书面词密集,合成出来念稿感很重。同样的引擎,把文稿改成口语化的短句,听感差别巨大。
三个具体改法:
拆长句。 一句话超过 30 字就考虑断开。人说话时会换气,长句合成出来是一口气念完的。
换掉书面虚词。 「其」「之」「乃」「故」这类改成口语说法。
加语气词和停顿。 适当的「那么」「其实」「另外」会让节奏自然,段落之间空一行也有帮助。
三个必须先改的坑
合成引擎对这三类内容的处理常常不符合预期,在文稿里就改成期望读法:
数字——「2026 年」可能被读成「二零二六」或「两千零二十六」;「3.5 万」的读法也不确定。重要的数字直接写成中文。
英文缩写——「API」是逐字母读还是当单词读,不同引擎不同。写成「A P I」可以强制逐字母。
多音字——「重」「行」「长」「解」在人名和专有名词里尤其容易错。这类改成同音替代或调整措辞。
语速怎么定
默认 1.0。
- 0.8~0.9——教学、说明类内容,给听众消化时间
- 1.0——默认,接近正常语速
- 1.1~1.2——资讯类、听众熟悉的内容
别用语速去凑时长。视频配音对不上时长,应该改文稿而不是加速——加速后的语音辨识度明显下降。
输出格式
WAV——无损,用于还要剪辑或混音的场景。
MP3——体积小,直接分发用。
一个现实的预期
合成语音在信息传达上已经够用,在情感表达上仍有明显差距。产品介绍、操作说明、知识讲解适合;需要情绪感染的内容(品牌片、故事)建议真人录。