
主题
记忆分 12 类:它把关于你的信息放在哪
记忆不是一坨聊天记录,而是 12 张分类卡片,每张一份可编辑的 Markdown。分类的铁律是边界必须机器可判——「这条该放哪」不能靠感觉,否则整理官每次都放错地方。
四组十二类
身份 · 关于我
| 类型 | 装什么 | 怎么来 |
|---|---|---|
| 我的身份 | 姓名、手机、邮箱、所在地 | 保存「用户信息」时同步,不参与自动整理(防臆造) |
| 用户画像 | 我是谁、职业、个人信息 | 对话与资料自动整理 |
| 用户能力 | 我已经会什么 | 自动整理 |
| 用户偏好 | 口味、习惯、喜好、取舍原则 | 自动整理 |
| 沟通风格 | 希望 AI 怎么跟我说话:语气、长度、语言 | 自动整理 |
经历
| 类型 | 装什么 | 与谁分界 |
|---|---|---|
| 重要经历 | 关键经历、里程碑、踩过的坑 | 全体系唯一「过去」槽 |
| 学习轨迹 | 正在学、想搞懂的 | 与「用户能力」的分界 = 在学 vs 已会 |
关系
| 类型 | 装什么 |
|---|---|
| 人脉关系 | 协作者、导师、常打交道的人 |
| 资源关系 | 我与上传资料的关系(「这是我的工作文档」「我对这个感兴趣」) |
目标与领域
| 类型 | 装什么 | 与谁分界 |
|---|---|---|
| 用户目标 | 我想达成的 | 「未来」 |
| 项目上下文 | 当前在做的项目 | 与「深耕领域」的分界 = 庄稼 vs 土壤 |
| 深耕领域 | 长期投入的行业与研究方向 | 同上 |
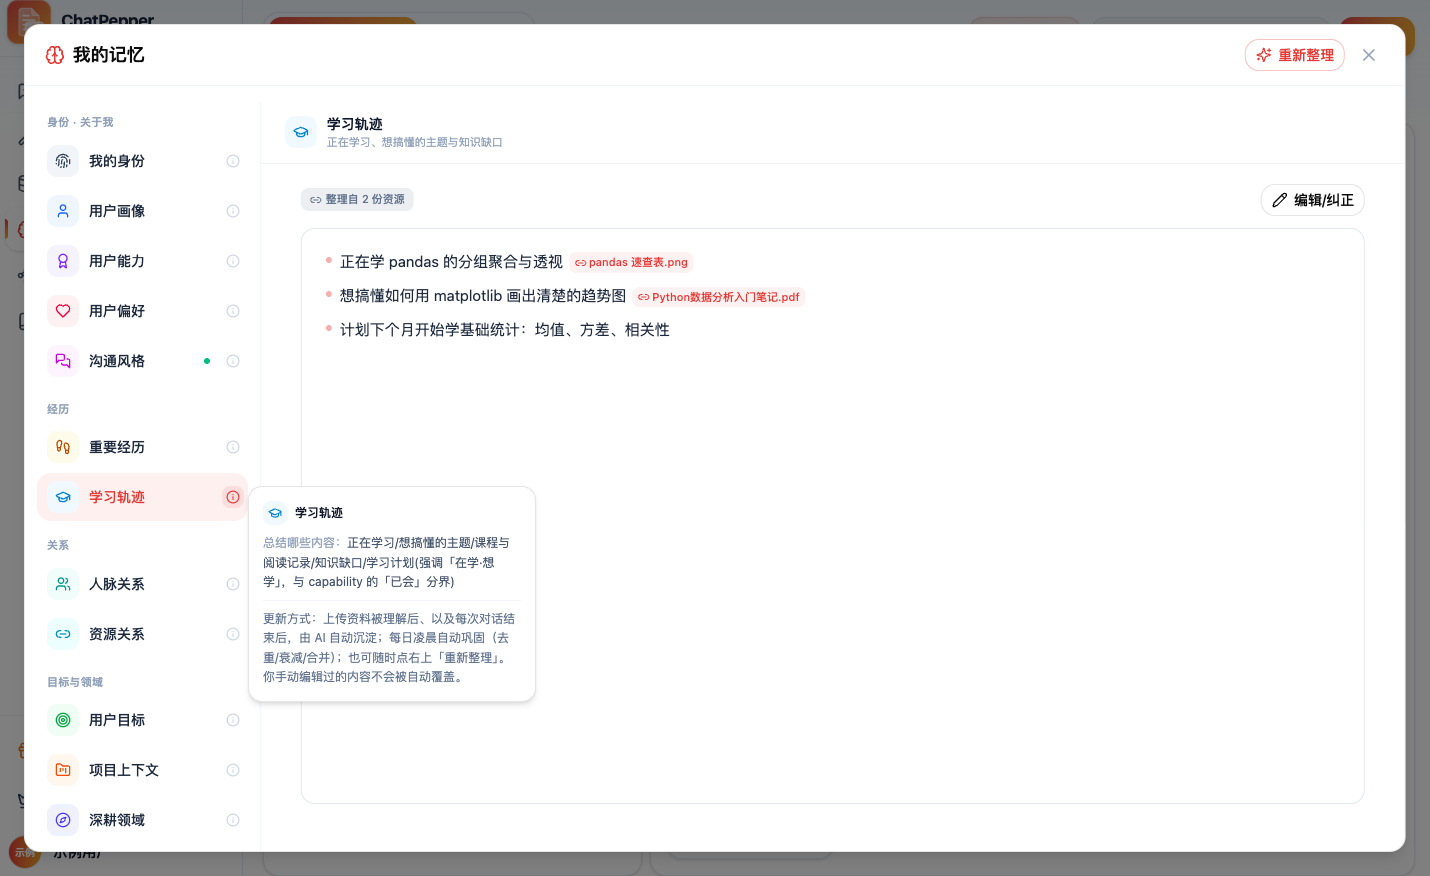
12 类记忆在「我的记忆」左栏按四组排列,点类型旁的 ⓘ 可查看这一类装什么、怎么更新(图中为示例数据)。
为什么没有「价值观」
曾经加过一个「价值观」槽,很快又删了。原因是它和「用户偏好」分不清——「我不喜欢啰嗦的回答」是偏好还是价值观?两边都说得通,整理官就会随机放。删掉后取舍原则并进偏好,边界重新变得可判。
这条教训后来成了加新类型的门槛:说不清和现有哪一类的边界,就不加。
每类怎么更新
- 我的身份:保存用户信息时即时覆盖
- 其余 11 类:上传资料后、对话累积一定量后自动整理;每天凌晨巩固一次;也可以手动「重新整理」
自动整理是保守增量:只追加、去重,不推翻。你手动编辑过的卡片会被标记,自动整理绕开它——这是你纠正记忆的保障。
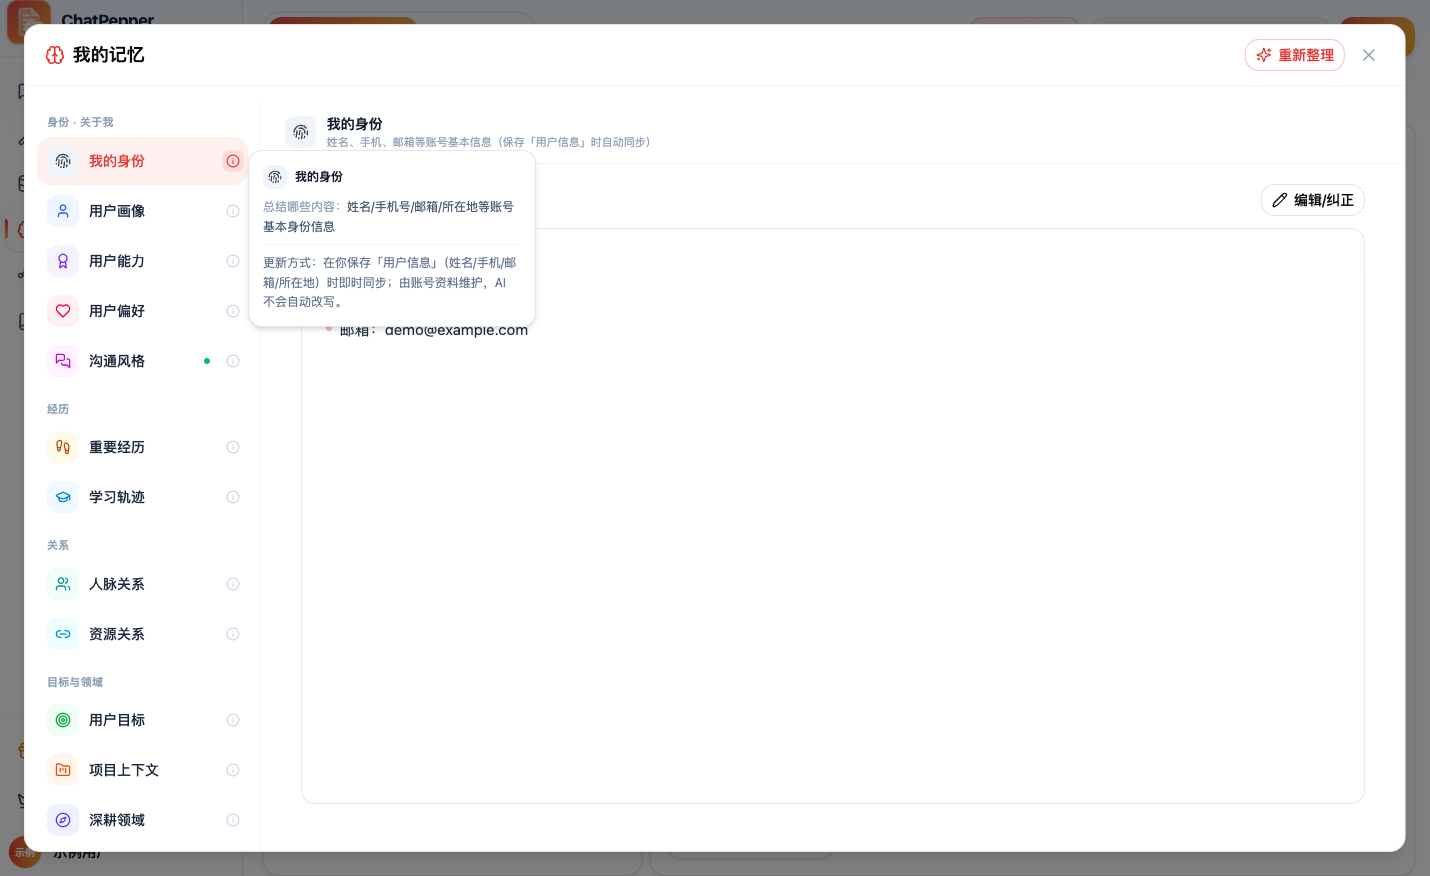
「我的身份」只在保存用户信息时同步,AI 不会自动改写(图中为示例数据)。
整理的原则
进记忆的内容必须先经过「源数据 → 可整理的文本」这一步:文档提正文、音频转写、视频抽帧描述、3D 模型转文本。整理官消费的是归一化文本,而不是原始文件。链路上的每个中间态都落库,出了问题能追溯。
整理官只采信你自己说的话沉淀画像,不会把你上传的一篇文章里作者的观点当成你的观点。