
主题
公式图转 LaTeX
论文里看到一个公式想引用到自己的文档,手敲 LaTeX 又慢又容易错——尤其是多层上下标、分式套分式、矩阵。截个图让模型认,比一个符号一个符号敲快得多。
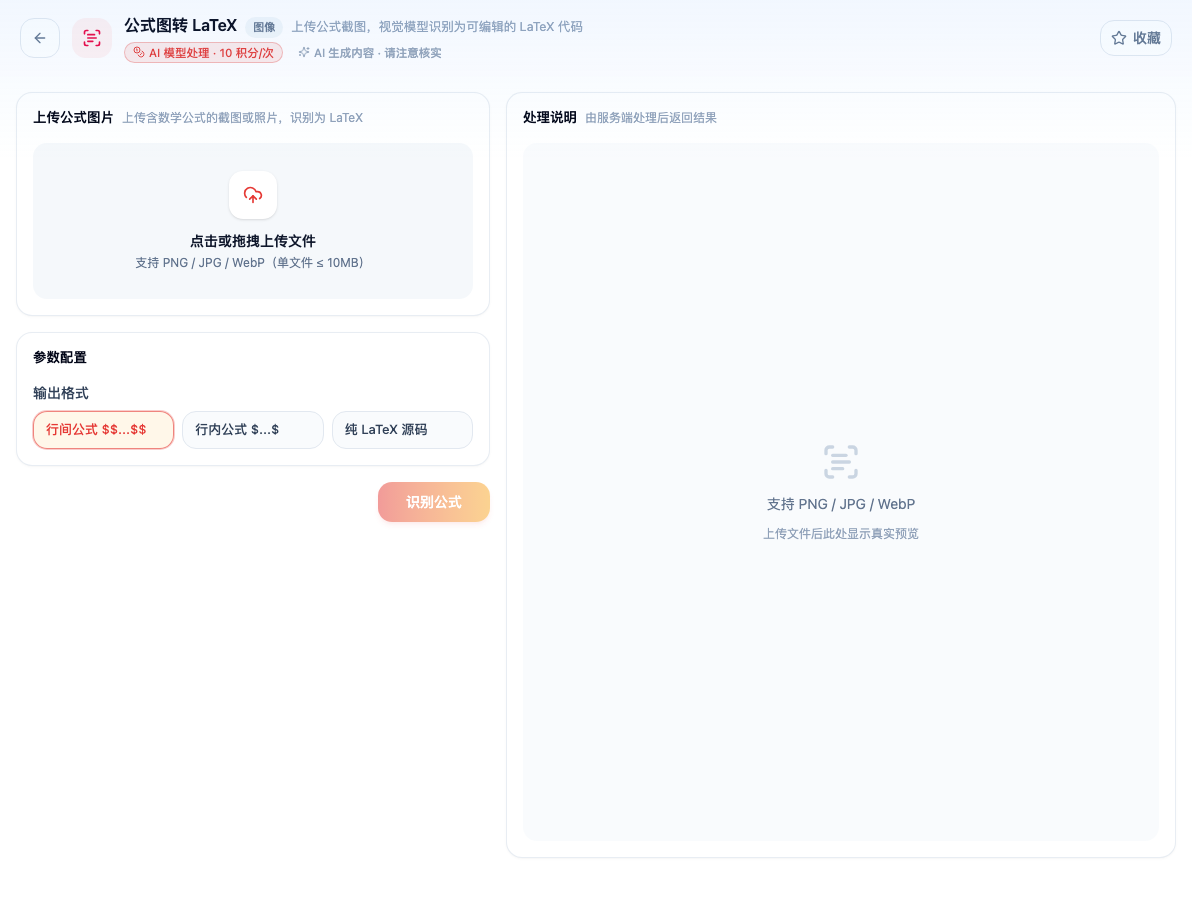
打开「公式图转 LaTeX」看到的初始界面。由 AI 模型处理,按次消耗积分(以页面标签为准)。AI 生成的结果请自行核实。
怎么截图能提高识别率
这一步决定了大半的效果:
只截公式本身。 把周围的正文、编号、图注都裁掉。多余内容会让模型试图把它们也当成公式的一部分。
截清楚。 从 PDF 里截图时先放大到 200% 以上再截。屏幕分辨率下的小字号公式,上下标会糊成一团。
背景干净。 有底纹、有批注划线的公式识别率明显下降。
两种输出格式
独立公式(display)——生成 \[ ... \] 或 $$...$$ 包裹的形式,公式单独占一行居中。用于正文中的重要公式。
行内公式(inline)——生成 $...$ 形式,嵌在文字里。用于「其中 $x$ 表示……」这类。
选错了不影响内容,改一下包裹符号即可。
必须核对渲染结果
这一步不能省。 识别对复杂公式仍会出错,而错误往往很隐蔽:
- 上下标位置错(
x_i^2与x^{i2}) - 括号层级错,但渲染出来看着差不多
- 相似符号混淆:
\alpha与a、\nu与v、\sum与\Sigma - 分式的分子分母边界判断错
做法:把生成的 LaTeX 粘进 LaTeX 公式编辑器 渲染出来,和原图并排比对。看图比读代码快得多,也更容易发现问题。
识别不出来怎么办
图太小 → 放大重截。
手写公式 → 识别率显著低于印刷体,复杂的基本认不出,需要手工录入。
整页截图 → 一次只截一个公式。同时给多个公式,模型可能把它们混在一起。
相关工具
- LaTeX 公式编辑器 —— 核对渲染结果、继续编辑
- PDF 转 Markdown —— 整篇论文的公式提取
- 图片 OCR 翻译 —— 图里是普通文字而非公式