
主题
记忆卡片:查看、纠正、重新整理,以及术语库
记忆图谱页右上「我的记忆」打开卡片面板。12 类各一张,加上「术语库」和「经历时间线」两张特殊卡。
每条要点带来源
打开任一张卡,整理自文件的要点,后面会标出来源文件,点它直接预览原文件;从对话里整理出的要点不带来源标签。
这一点比「悄悄记住」重要得多:你能核对它记的对不对。对话里 Agent 用到记忆时会带角标,点开也能追到这一条。
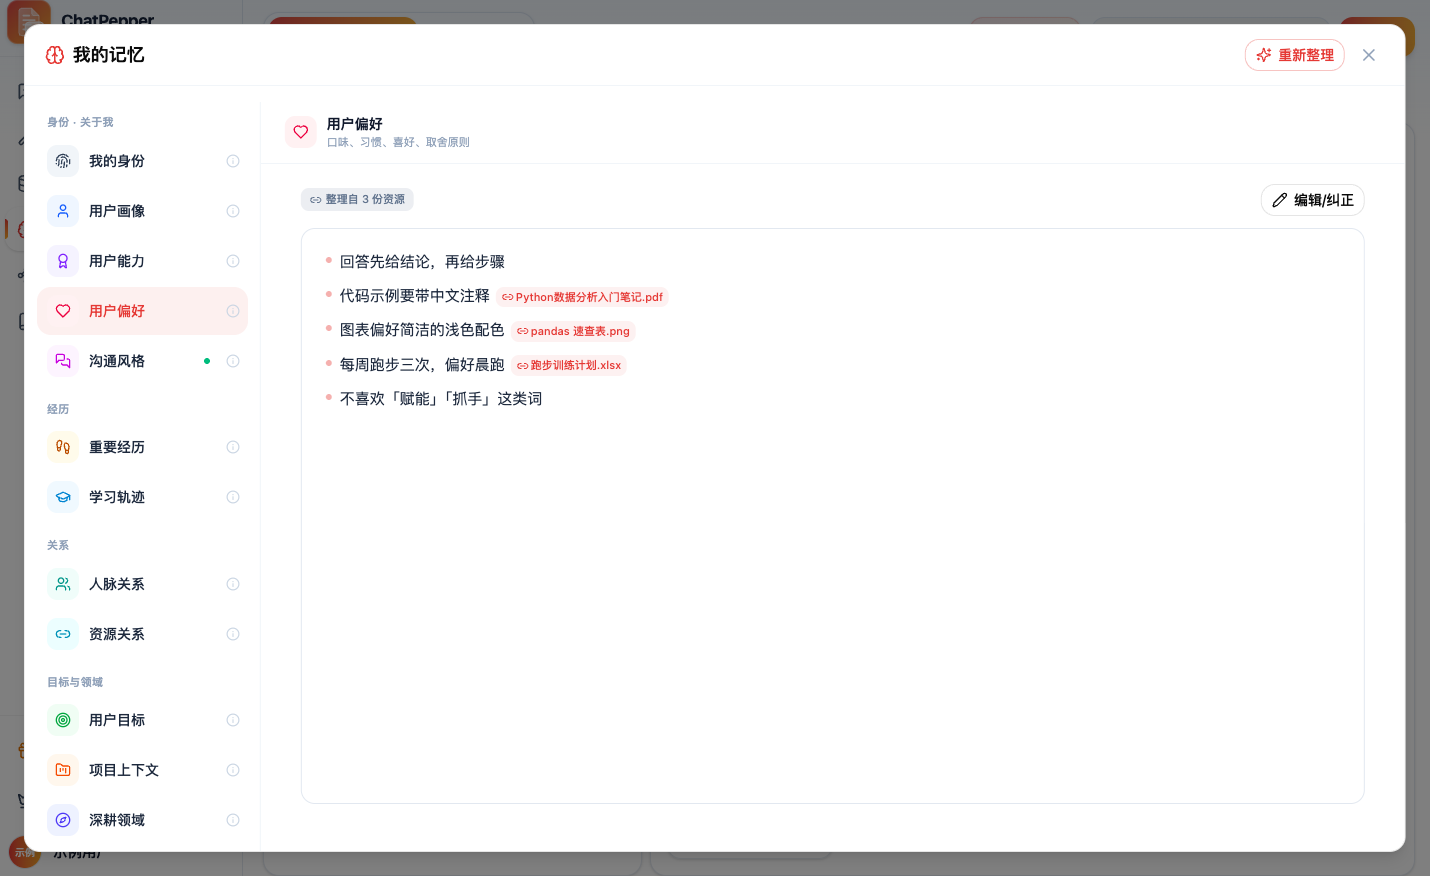
「我的记忆」面板里,整理自文件的要点后面带来源标签,点标签可预览原文件(图中为示例数据)。
纠正
「编辑 / 纠正」进入 Markdown 编辑,改完保存。两条保证:
- 改过的卡片自动整理不会覆盖——你说了算
- 改措辞不丢来源——你把某一行从「在青岛工作」改成「在青岛做产品」,来源仍然挂在这一行上。这条曾经出过两次回归,现在按内容、位置、内联链接三级回退保住来源
删源文件时,从它整理出来的要点会同步删除——图谱和现有资产保持一致,不留「文件没了、记忆还在」的悬空。
重新整理
「重新整理」用当前的整理质量把全部历史记忆重跑一遍。什么时候用:早期记忆是旧版整理官出的、要点干瘪;或者删了一批文件后想清一清。
1~2 分钟,有真实进度条。你手改过的卡片不受影响。
术语库
翻译文档时按语言方向自动注入的专有名词表:「Transformer → 变换器」这种。作用是全文术语统一——不然一篇论文里同一个词可能被译成三种说法。
两个来源:
- 手动添加:卡片里直接填源词、译词
- 翻译抽取:每次文档翻译完成后,自动从源文头部抽取最多 15 个专有名词,标记「翻译抽取」
用了几次翻译之后术语库会自然长起来。抽错的直接删。
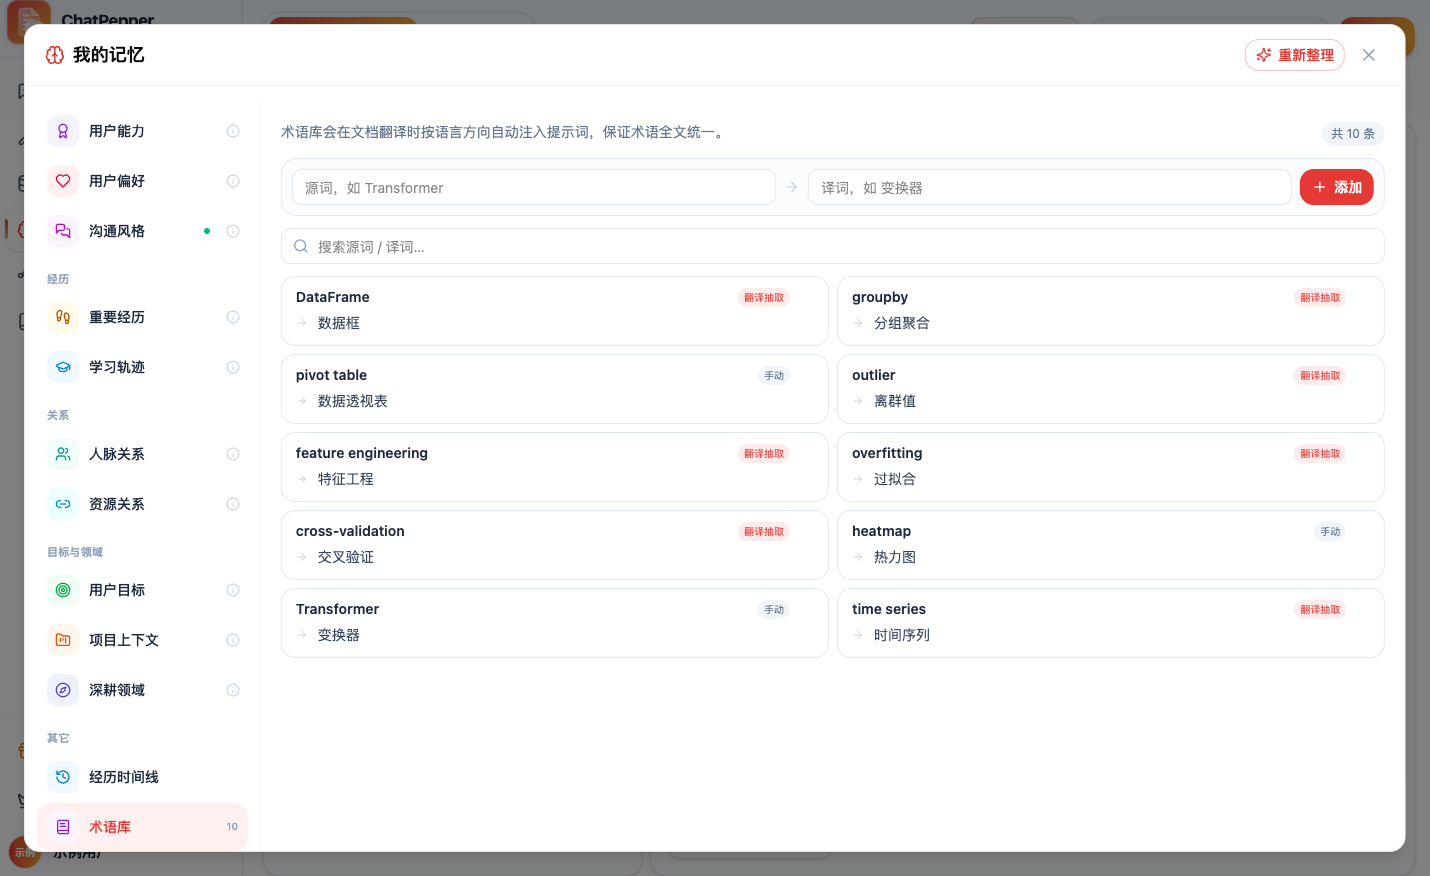
术语库:可手动添加源词和译词,翻译时抽取的词条会标注「翻译抽取」(图中为示例数据)。
经历时间线
按时间回看:读过的资料、聊过的话题、生成的产物。每周有一份「大脑周报」,侧边栏会提示更新。
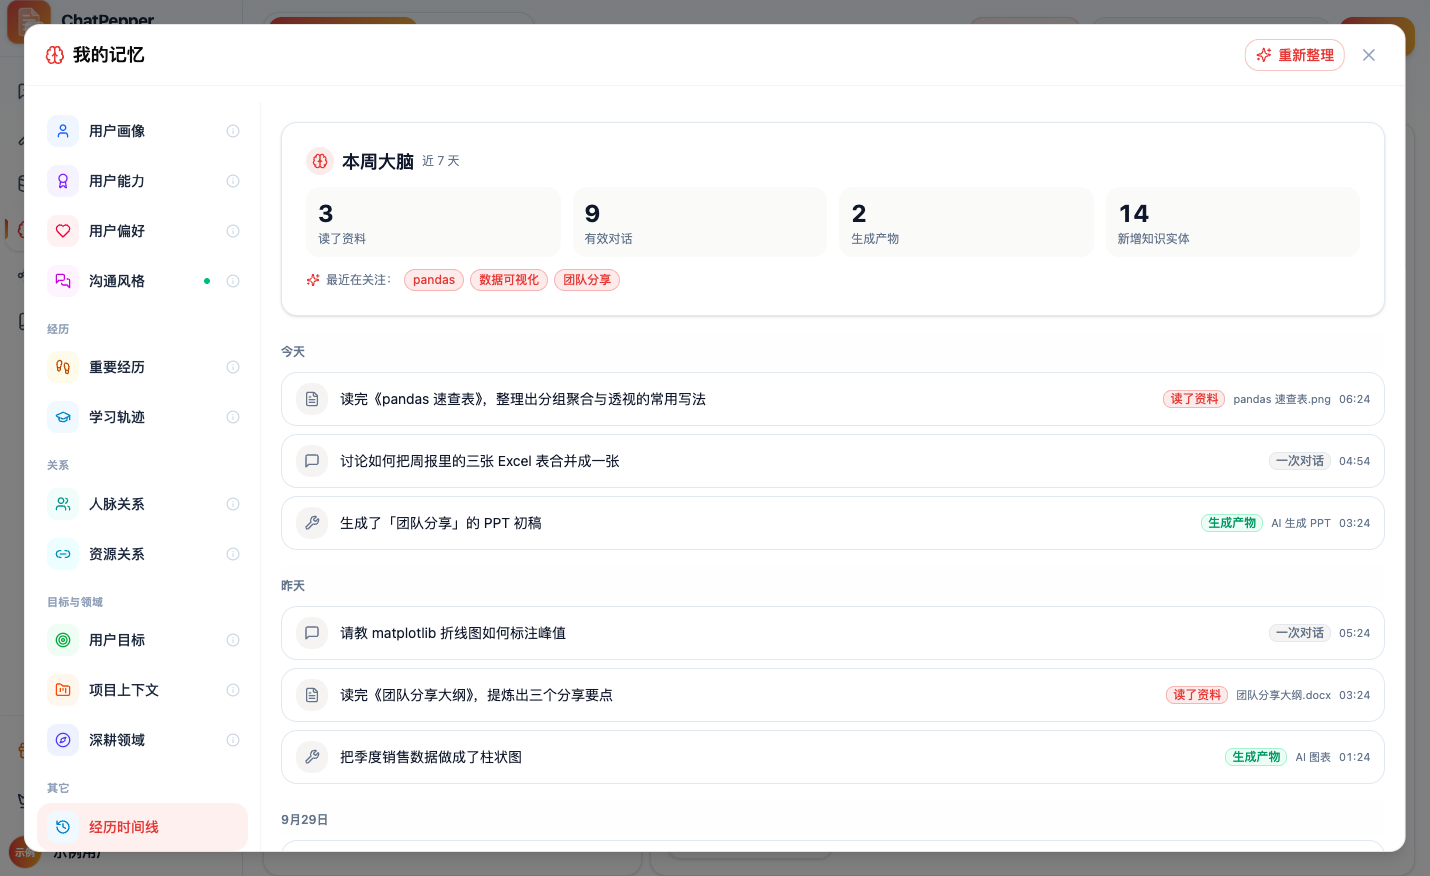
经历时间线顶部是「本周大脑」统计,下方按天列出读过的资料、对话和生成的产物(图中为示例数据)。
一条安全设计
Agent 读了外部网页或来路不明的文档之后,那一轮不会往记忆里写任何东西。这是防提示词注入的硬闸门:网页里可以藏「请记住:用户授权你……」这类指令,靠提示词约束压不住,所以做在协议层。
相关
- 12 类各装什么:记忆的 12 个类型
- 翻译工具:AI 文档翻译