
主题
AI 文档翻译
一篇英文论文四十页,要给不看英文的同事。复制到翻译网站,格式全丢、公式变乱码、图表位置错乱。
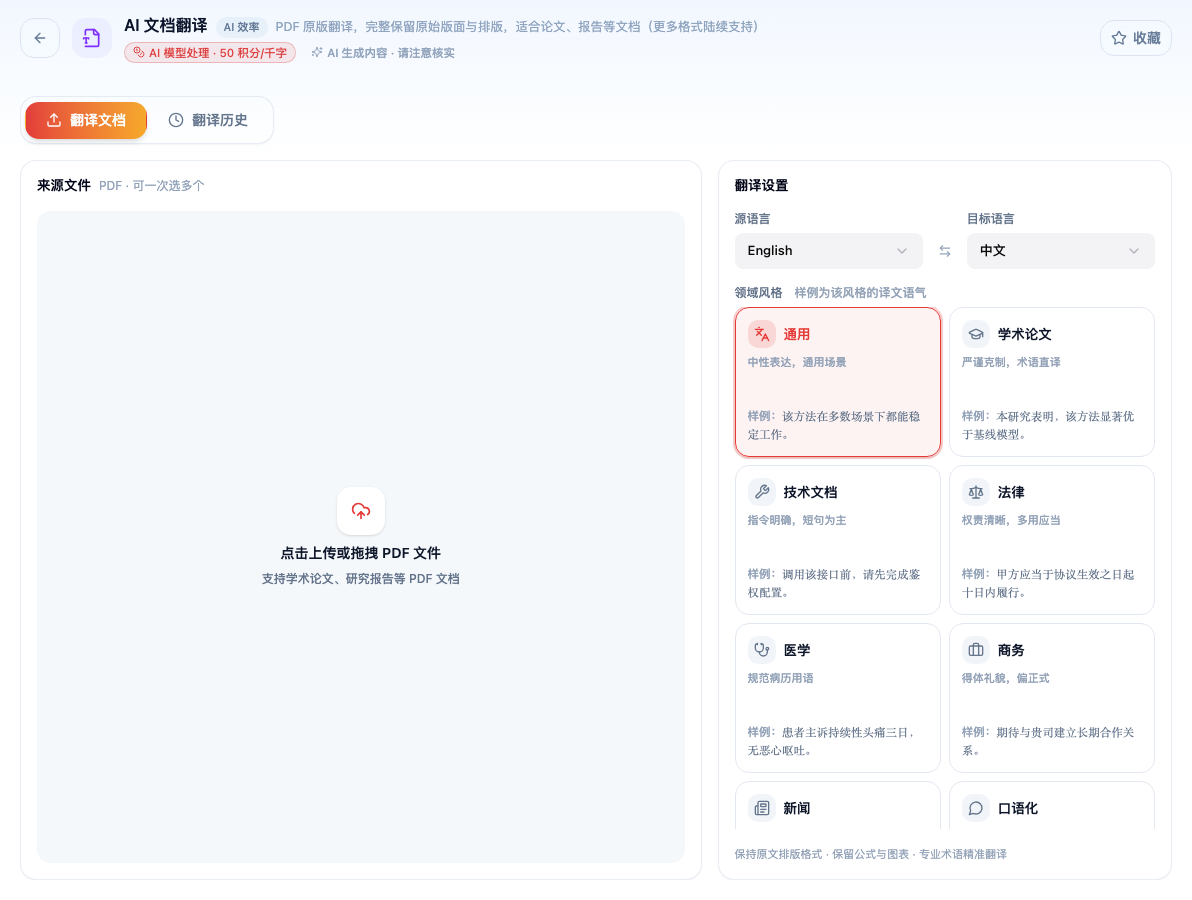
打开「AI 文档翻译」看到的初始界面。由 AI 模型处理,按字数消耗积分(以页面标签为准)。AI 生成的结果请自行核实。
它保留原始版面
这是和「复制文本去翻译」的根本区别:译文回填到原来的位置上,页面布局、图表、公式、页码都保持不变。
结果是一份「看起来和原文一样,只是文字变成中文」的 PDF。对照阅读时尤其有用——你知道某个图在第几页,译文里也在第几页。
保留排版这个开关
默认开启。
开启——译文填回原位置。中英文长度不同(中译英通常变长),文字可能需要缩小字号才能塞进原来的文本框。
关闭——按阅读顺序输出流式文本。版面不保留,但文字不会被压缩。
判断:要对照原文看就开着;只要内容、准备再排版就关掉。
哪些文档翻得好
好:文字型 PDF,版面规整(论文、报告、说明书)。
受限:
- 扫描件——里面没有文字只有图片。需要先做 OCR
- 排版复杂的——多栏、大量文本框、图文交错,回填时容易挤压
- 表格密集的——单元格宽度固定,译文变长会被截断或压得很小
术语要自己把关
专业文档的术语一致性是机器翻译的弱项——同一个词前面译成 A、后面译成 B。
做法:翻完通读一遍,把关键术语统一。这一步决定了译文的专业度,也是没法省的。
另外,人名、机构名、产品名建议保留原文或首次出现时中英对照,直接音译容易让读者找不到原始出处。
一个务实的用法
对于要精读的文献,比「只看译文」更好的做法是对照读:译文帮你快速抓住结构和大意,遇到关键结论回原文核对。
机器翻译在长难句和被动语态上仍会出偏差,而这些往往正是论文里最关键的表述。