
主题
密码里加个感叹号,到底管不管用
注册页面上那个「密码强度:弱/中/强」的进度条,多数时候只是在数你用了几类字符。加个感叹号就从黄变绿——但真正决定密码能扛多久的,是另一回事。
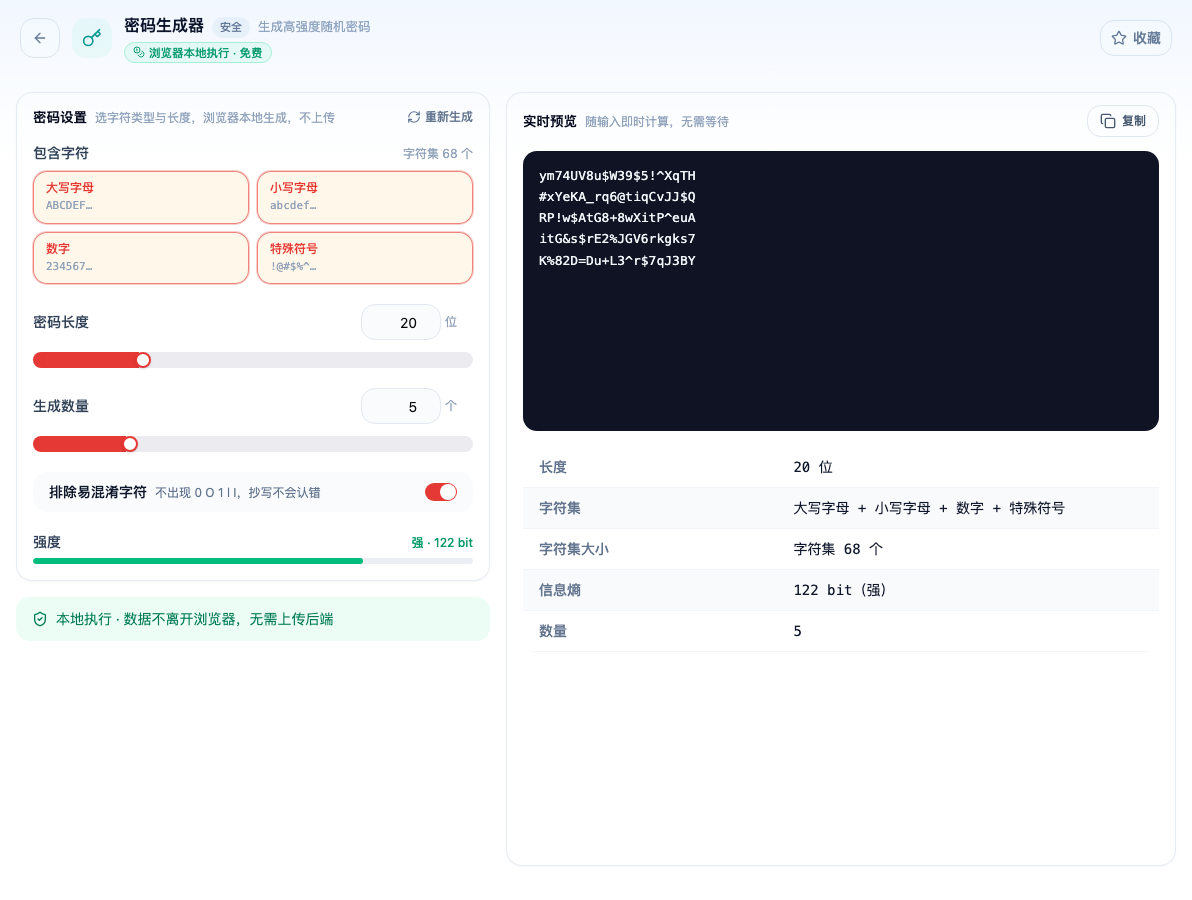
打开「密码生成器」看到的初始界面。在浏览器本地完成、数据不离开浏览器,免费。
强度可以算出来
衡量随机密码强度的标准单位是熵(bit)。公式很短:
熵 = log₂(字符集大小) × 密码长度字符集大小指每一位可能的取值数量。四类字符全开时:
| 字符类别 | 数量 |
|---|---|
| 大写字母 A–Z | 26 |
| 小写字母 a–z | 26 |
| 数字 0–9 | 10 |
符号 !@#$%^&*-_=+[]{}<>?,.;:/|~ | 26 |
| 合计 | 88 |
每多 1 bit,破解所需的尝试次数翻一倍。
长度和字符集,哪个更值
这是本文想说清楚的核心。看一组实算:
| 组成 | 长度 | 字符集 | 熵 |
|---|---|---|---|
| 仅小写 | 8 | 26 | 38 bit |
| 大小写 + 数字 | 8 | 62 | 48 bit |
| 大小写 + 数字 | 12 | 62 | 71 bit |
| 大小写 + 数字 + 符号 | 12 | 88 | 78 bit |
| 大小写 + 数字 | 16 | 62 | 95 bit |
| 大小写 + 数字 + 符号 | 16 | 88 | 103 bit |
对着这张表看两组对比:
- 加符号:12 位密码从 62 字符集扩到 88 字符集,71 → 78 bit,多 7 bit。
- 加长度:同样是 62 字符集,从 12 位加到 16 位,71 → 95 bit,多 24 bit。
多打 4 个字符带来的强度提升,是加一整类符号的三倍多。而且 16 位纯字母数字比 12 位带符号的密码强得多(95 vs 78),还更好输入——手机上切符号键盘是实实在在的摩擦。
结论:长度优先。 需要记住的密码尤其如此。
「排除易混淆字符」要付出什么
很多生成器有个「排除 0/O/1/l/I」选项,抄写密码时确实省事。代价是字符集变小:
四类全开、排除易混淆字符后,字符集从 88 降到 68,12 位密码的熵从 78 bit 降到 73 bit——少 5 bit。
这 5 bit 值不值,取决于场景:要手抄或口头念给别人的密码,值;存在密码管理器里从不手输的,不值,白丢强度。
比熵更重要的一件事
以上所有计算都建立在一个前提上:每一位都是真随机的。
P@ssw0rd! 这个密码字符集全开、长度 9 位,按公式算有 58 bit。但它在任何一份常用密码字典里都排在前列,实际强度接近于零。公式算的是「如果攻击者只能逐个穷举」,而现实中攻击者会先跑字典和常见替换规则(a→@、o→0、i→1)。
同理,「把生日改成 1990!」「公司名 + 年份」这类,无论多长、多少类字符,熵的计算都不适用——它们的搜索空间不是 88ⁿ,而是一份很短的名单。
随机数本身也可能有偏
最后一个容易被忽略的细节:生成器怎么把随机字节映射到字符集。
最直觉的写法是 随机字节 % 字符集长度。当字符集长度不是 2 的整数次幂时(88 和 68 都不是),这行代码会让靠前的字符出现得更频繁——这叫取模偏置。偏置量级很小,任何抽样统计都验不出来,但它确实削弱了随机性。
正确做法是拒绝采样:落在不完整区间里的随机值直接丢弃重取。密码生成器 用的是这个方案,并且保证每个勾选的字符类别至少出现一次(否则「勾了符号却一个符号都没有」的密码,实际字符集并没有你以为的那么大)。
生成全部在浏览器本地完成,密码不上传。
熵只衡量随机生成密码的强度。对人为构造的密码,任何强度计算都会高估——用生成器,别自己编。