
主题
UUID 生成
要给一批记录生成唯一 ID,或者做测试数据需要一堆不重复的标识。
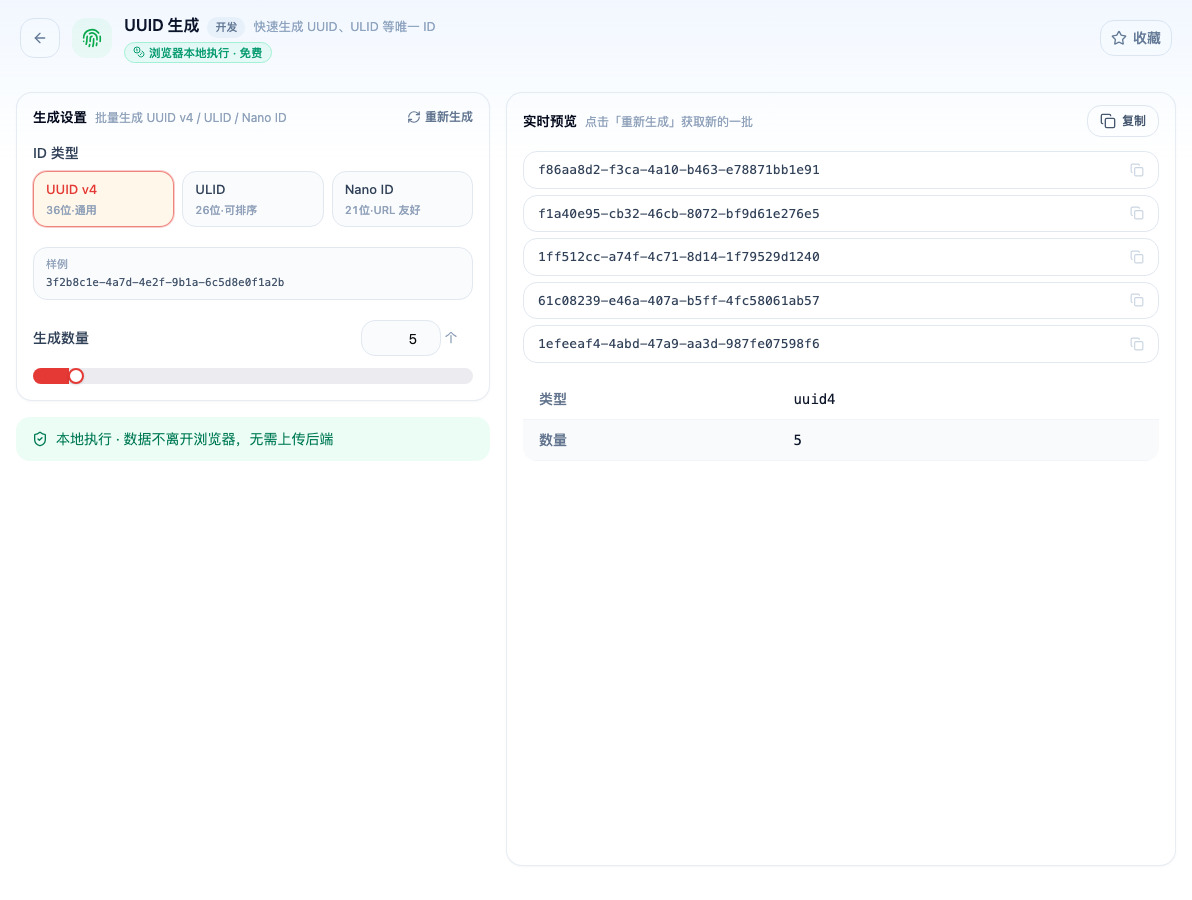
打开「UUID 生成」看到的初始界面。在浏览器本地完成、数据不离开浏览器,免费。
三种 ID 的区别
| 类型 | 样子 | 特点 |
|---|---|---|
| UUID v4 | f47ac10b-58cc-4372-a567-0e02b2c3d479 | 纯随机,无序 |
| UUID v7 | 同格式但前缀含时间 | 随机 + 按时间有序 |
| ULID | 01ARZ3NDEKTSV4RRFFQ69G5FAV | 26 位,按时间有序,更短 |
为什么「有序」很重要
这是选型的关键,也是最容易被忽略的一点。
UUID v4 是纯随机的。用它做数据库主键时,每次插入的位置在索引里都是随机的——B+ 树索引会频繁分裂和重排,写入性能随数据量增长明显下降。
UUID v7 和 ULID 把时间戳放在前缀,所以新生成的 ID 总是排在后面,插入永远发生在索引末端,不会引起页分裂。
结论:
- 做数据库主键 → 用 v7 或 ULID
- 做临时标识(请求 ID、文件名、幂等键) → v4 就够,随机性反而是优点
ULID 的额外好处
26 个字符,比 UUID 的 36 个短,而且不含连字符——放进 URL、文件名、日志里都更省事。
用的是 Crockford Base32 编码,刻意排除了容易混淆的 I、L、O、U,人工抄写时不容易出错。
不要用自增 ID 暴露业务量
顺带一个安全考虑:用自增整数做对外可见的 ID(订单号、用户 ID),等于把业务量公开——别人注册两个账号,一减就知道你两次注册之间来了多少用户。
这也是 UUID 类 ID 的价值之一:对外标识用它,内部主键才用自增。
生成数量
一次可以生成多条。做测试数据时批量生成很方便。
注意 UUID v4 的碰撞概率极低(理论上生成 103 万亿个才有百万分之一的概率撞一次),日常使用不需要考虑去重。
浏览器本地处理
在你的浏览器里生成,不经过网络。